(01)
データとAIを統合する
「レイクハウス」アーキテクチャ
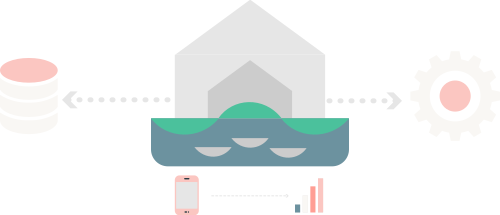
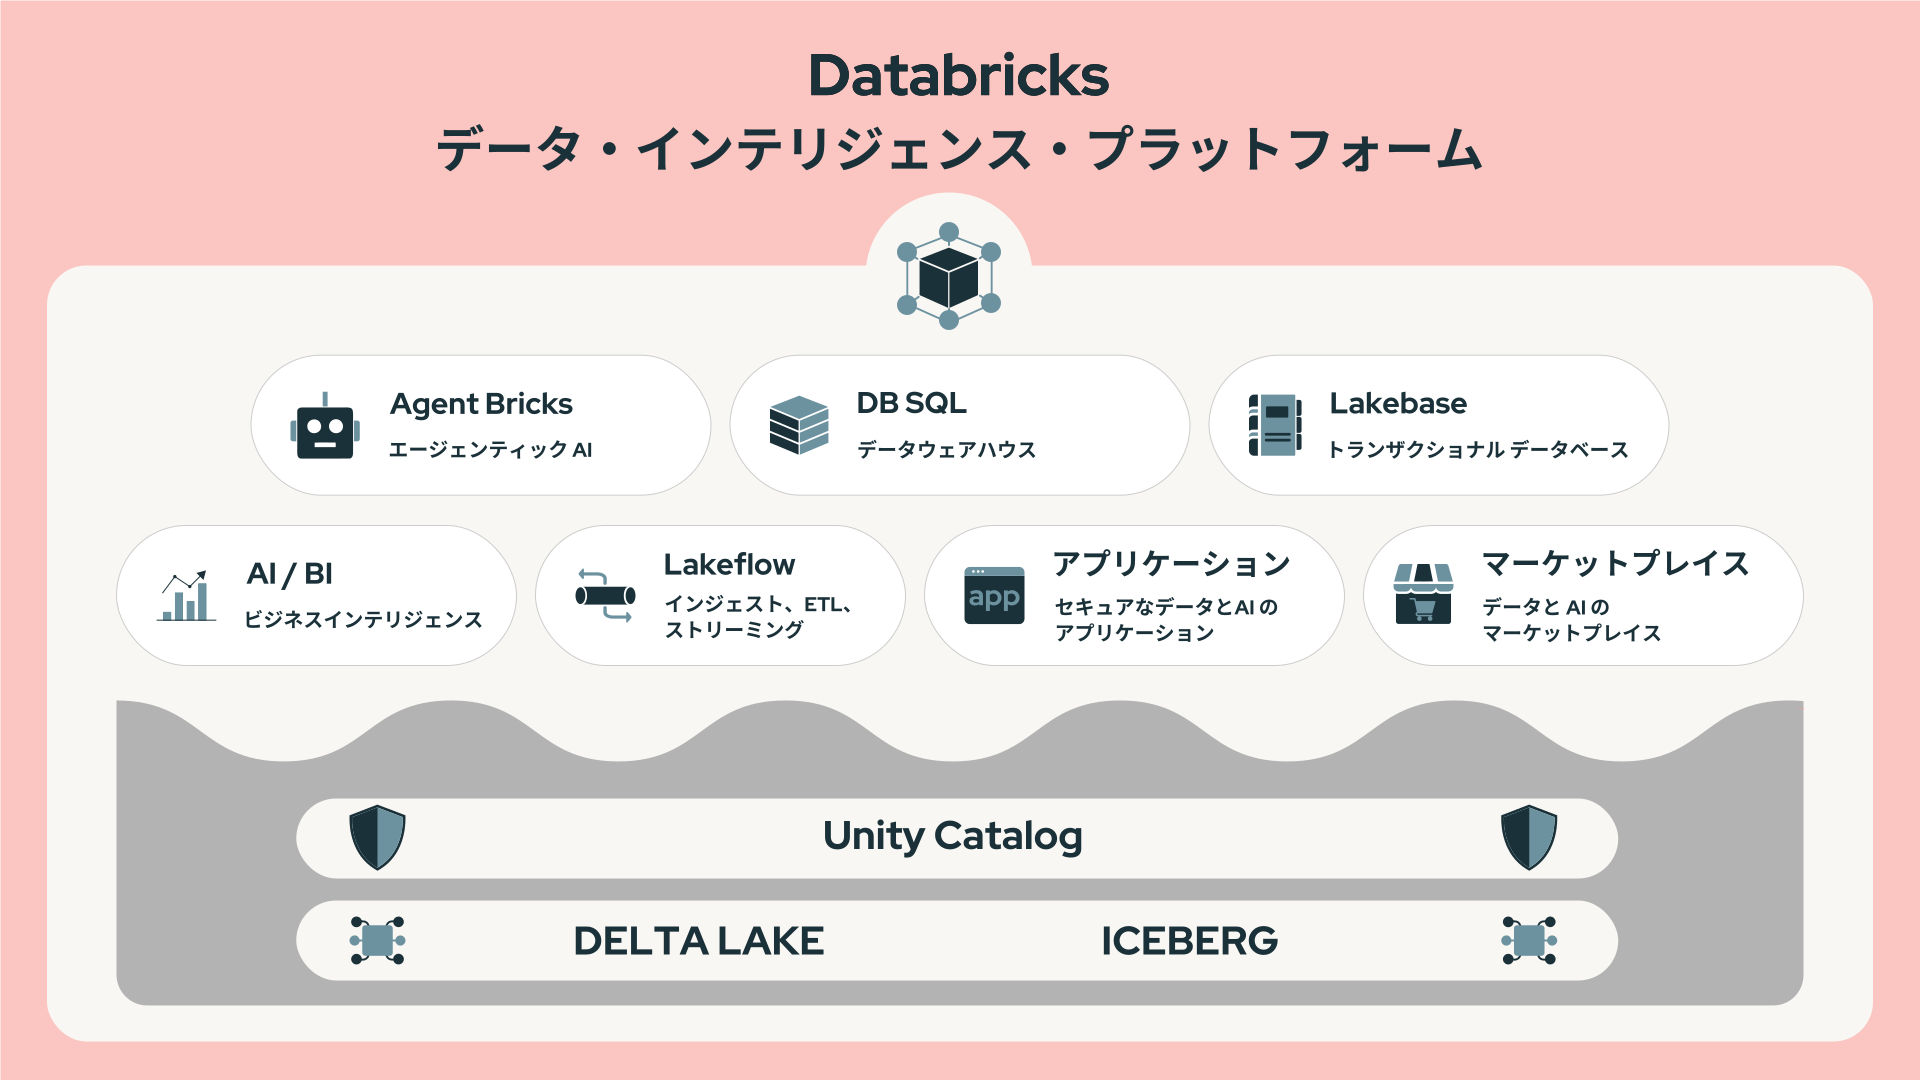
データレイクの柔軟性とデータウェアハウスの信頼性を両立。
構造化・半構造化・非構造化データを単一基盤で扱い、分析からAI活用までを一気通貫で実現します。
データは溜まっているが、意思決定やビジネス成果にうまく結びついていない
リアルタイム分析や高度なAI活用に取り組みたいが、基盤や運用が追いつかない
PoC止まりで、本番業務にAIや分析を活かしきれていない
用途ごとに基盤やツールが乱立し、全体像が把握できない
データ処理や分析のたびに運用負荷やコストが増えていく
ストリーミング処理や高度分析を既存基盤で扱うのが難しい
データ分析、BI、機械学習、AI開発が分断されている
新しい分析やAI活用を始めるたびに時間と調整コストがかかる
小さく始めたいが、将来的な拡張性に不安がある
(01)
データレイクの柔軟性とデータウェアハウスの信頼性を両立。
構造化・半構造化・非構造化データを単一基盤で扱い、分析からAI活用までを一気通貫で実現します。
(02)
ペタバイト級のデータにも対応可能な分散処理エンジンを搭載。
バッチ・ストリーミングを問わず高パフォーマンスで処理し、ビジネス意思決定を加速します。
(03)
高信頼なデータパイプラインの構築・運用を効率化。
データ品質管理やスキーマ管理を標準化し、安定したデータ活用基盤を整備します。
(04)
直感的なSQL分析はもちろん、Python・R・Scalaなど多様な言語に対応。
BIツールとの連携も容易で、現場部門からデータサイエンティストまで幅広く活用できます。
(05)
特徴量生成、実験管理、モデル登録、本番デプロイまでを統合。
AIプロジェクトの属人化を防ぎ、継続的な改善とスケールを可能にします。
(06)
AWS・Azure・Google Cloudに対応。
既存環境を活かしながら、将来的な拡張にも柔軟に対応できる分析基盤を構築できます。
01
Databricks導入の目的整理から、実装を前提としたアーキテクチャ設計・環境構築までを一気通貫で支援します。
DX推進や高度分析活用などのビジネス要件を起点に、データ基盤に求められる機能・性能・拡張性を具体化します。 対象データのスコープ定義、ロードマップ策定、実行可能なスケジュールおよび概算コストの整理を行い、実装フェーズへ接続可能な設計方針を確立します。
AWS、Azure、GCPにおけるネットワーク設計(VPC/VNet設計)、IAM設計、監査ログ設計を含むセキュアな基盤を構築します。 可用性・拡張性・ガバナンスを考慮した構成を採用し、将来的なスケールを見据えたアーキテクチャを実装します。
02
分散したデータ資産を統合し、分析・AI活用を前提としたデータ基盤を構築します。
基幹システムや外部サービスからのデータ連携処理を設計・実装します。 ETL/ELT処理の自動化、データ品質管理、更新サイクル設計を行い、メダリオンアーキテクチャに基づく多層データモデルを構築します。
Unity Catalog等を活用し、アクセス制御、データ分類、監査ログ管理を実装します。 個人情報保護や社内統制要件を踏まえた権限制御・マスキング設計を行い、エンタープライズ利用に耐えうる統制基盤を整備します。
03
データ活用を実行可能な状態にするための開発・分析基盤を整備します。
部門・用途に応じたワークスペース設計、クラスタ構成設計、リソース管理ポリシー策定を行います。 パフォーマンスとコスト効率を両立する実行環境を構築し、継続的な改善が可能な設計を採用します。
モデルのバージョン管理、デプロイメントフロー、精度モニタリング、再学習基盤を設計・構築します。 PoCで終わらないAI活用を実現するため、運用を前提とした仕組みを実装します。